サーチのアルゴリズム|つまづきやすいポイントと攻略法 徹底解説!
2026-09-28 更新
この連載は、基本情報技術者試験の受験者を対象としたものです。
毎回1つのテーマにしぼって、多くの受験者がつまづきやすいポイントと攻略法を解説します。
今回のテーマはサーチのアルゴリズムです。
サーチのアルゴリズムの種類
サーチ(search)とは、配列の中から目的の値を探索することです。
基本情報技術者試験の知識と技能の細目を示したシラバスという資料には、サーチのアルゴリズムとして、線形探索法、二分探索法、ハッシュ表探索法が示されています。
科目Aには、これらのアルゴリズムの仕組みに関する問題が出ます。
科目Bには、これらのアルゴリズムを擬似言語で示したプログラムを読み取る問題が出ます。
したがって、サーチのアルゴリズムの問題を攻略するには、それぞれのアルゴリズムの仕組みを理解することは当然ですが、それぞれのアルゴリズムをプログラムで経験することも必要です。
サーチのアルゴリズムの仕組み
サーチのアルゴリズムの仕組みを理解するには、この連載の第10回で取り上げたソートのアルゴリズムと同様に、それぞれのアルゴリズムを手作業でやってみるとよいでしょう。
教材(受験者であれば何らかの教材をお持ちでしょう)でアルゴリズムの説明を読んだら、カードに数字を書いたものを配列の要素に見立てて、手作業でサーチをやってみるのです。
【線形探索法】
線形探索法は、ランダムな(ソートされていない)配列を対象としたアルゴリズムです。配列の先頭から末尾に向かって要素を順番にチェックしていきます。まっすぐ順番にチェックするから「線形」と呼ぶのです。
線形探索法を手作業でやるときは、ランダムな順序のカードを一直線に並べて裏返し、目的の値を決めたら、先頭から1枚ずつ順番にめくっていきます。これを目的の値が見つかるか、最後の1枚をめくって見つからないと判断するまで繰り返します。
【二分探索法】
二分探索法は、ソートされている配列を対象としたアルゴリズムです。配列の真ん中の要素の値をチェックして、目的の値より大きければ前側に探索対象を絞り込み、目的の値より小さければ後側に探索対象を絞り込みます(昇順にソートされている場合です)。探索対象を二分割するから「二分」と呼ぶのです。
二分探索法を手作業でやるときは、ソートされたカードを一直線に並べて裏返し、目的の値を決めたら、真ん中をめくってチェックし、探索対象を前側か後側に絞り込みます。これを目的の値が見つかるか、最後の1枚をめくって見つからないと判断するまで繰り返します。
【ハッシュ表探索法】
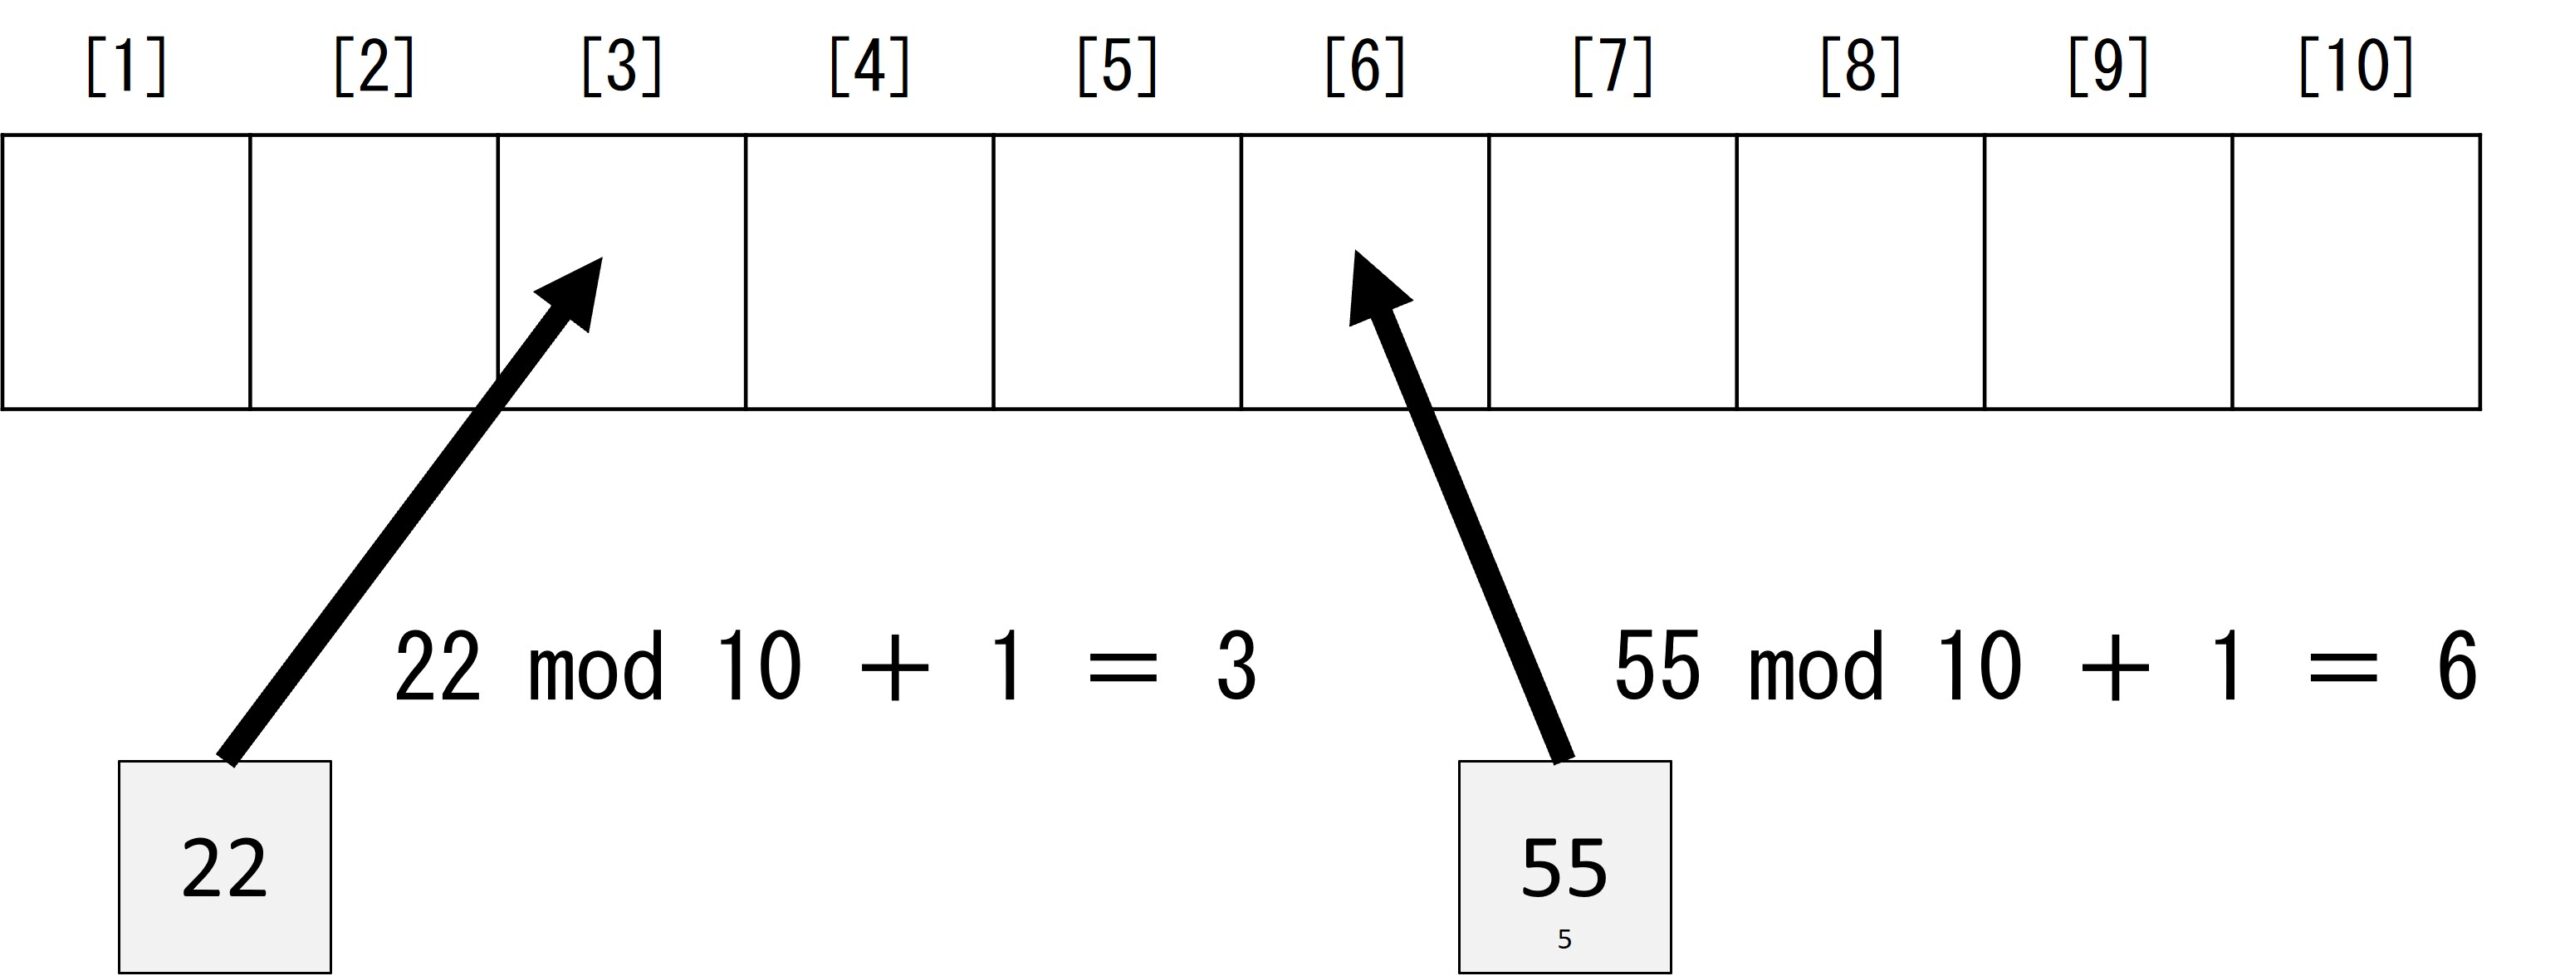
ハッシュ表探索法は、要素の値をハッシュ関数(あらかじめ用意しておいた計算式)で計算し、計算結果の値を格納場所とするものです。たとえば、「要素の値 mod 10 + 1」というハッシュ関数なら、22という要素は、22 mod 10 + 1 = 3なので、配列の3番目に格納します。この仕組みで要素を格納すると、理想的には、目的の値が1回の処理で見つかります。値がわかれば、格納場所がわかるからです。ここで、理想的と断っているのは、たとえば22と32のように、格納場所が同じになってしまう要素もあるからです。この場合には、他のハッシュ関数を使って格納場所を決めたり、その場所より先で最初に空いている場所に格納したりします。
ハッシュ表探索法を手作業でやるときは、図1に示したように、紙の上に枠と番号を書いた表を要素の格納場所として、そこにカードを格納していきます。この表を「ハッシュ表」と呼びます。格納が終わったら探索します。目的の値から格納場所がわかります。
サーチのアルゴリズムのプログラム
仕組みを理解できたら、それぞれのアルゴリズムをプログラムで経験しておきましょう。
擬似言語では、プログラムを動作させられないので、JavaやPythonなどのプログラミング言語を使ってください。
インターネットで「Java 二分探索法」や「Python 二分探索法」のようにプログラミング言語とアルゴリズムの名称をスペースで区切って検索すれば、プログラムを掲載しているページがいくつか見つかりますので、それらを参考にしてプログラムを作って動作を確認してください。
例として、リスト1に、Pythonで作った二分探索のプログラムを示します。
このプログラムは、配列dataの中からtargetと同じ値の要素を探索し、見つかった場合は要素番号を返し、見つからない場合は-1を返すsearch関数と、それを使う処理から構成されています。
このsearch関数は、後で示す科目Bの問題の擬似言語のプログラムを、Pythonに書き換えたものです。
# search関数の定義
def search(data, target):
    low = 0
    high = len(data)

    while low <= high:
        middle = (low + high) // 2
        if data[middle] < target:
            low = middle + 1
        elif data[middle] > target:
            high = middle - 1
        else:
            return middle

    return -1

# search関数を使う処理
data = [11, 22, 33, 44, 55, 66, 77]
target = int(input("目的の値-->"))
print(search(data, target))
図2に、プログラムの実行結果の例を示します。
Pythonでは、配列の要素番号が0から始まるので、11, 22, 33, 44, 55, 66, 77という配列の中から55を見つけた結果として、4が表示されています。
なお、後で示す擬似言語のプログラムでは、配列の要素番号が1から始まります。
C:\sample>python search.py
目的の値-->44…目的の値をキー入力する
3…見つかった要素番号が表示される
サーチのアルゴリズムの科目Aの問題の例
サーチのアルゴリズムをテーマとした科目Aと科目Bの問題を見てみましょう。
アルゴリズムの仕組みを理解していれば科目Aの問題を解けますが、プログラムを経験していないと科目Bの問題を解けないことがわかるはずです。
以下は、科目Aの問題(出典:H26秋問6)です。
問題(出典:H26秋問6)
2分探索に関する記述のうち,適切なものはどれか。
ア 2分探索するデータ列は整列されている必要がある。
イ 2分探索は線形探索よりも常に速く探索できる。
ウ 2分探索は探索をデータ列の先頭から開始する。
エ n 個のデータの2分探索に要する比較回数は,n log2n に比例する。
二分探索法は、探索対象の配列がソートされている必要があるので、選択肢アは適切です。
正解は、選択肢アでよいのですが、念のため他の選択肢も見ておきましょう。
二分探索法は、線形探索法より効率がよいアルゴリズムですが、常に速く探索できるとは限りません。
たとえば、配列の先頭に目的の値がある場合には、先頭からチェックする線形探索法の方が、真ん中をチェックする二分探索法より速く探索できます。
したがって、選択肢イは不適切です。
配列の先頭から探索を開始するのは、二分探索法ではなく線形探索法なので、選択肢ウは不適切です。
アルゴリズムの効率を示す方法として計算量があります。
計算量は、n個のデータを処理するときの最大の処理回数を、nを使った式で示したものです。
選択肢エは、二分探索の計算量の記述です。
二分探索の計算量は、二分割を繰り返して最後の1個になるまでの処理回数でありlog2nという式で示せます。
したがって、選択肢エは不適切です。
サーチのアルゴリズムの科目Bの問題の例
以下は、科目Bの問題(出典:サンプル問題セット問13)です。
関数searchに不具合(誤り)があるので、引数dataの内容によっては無限ループ(永遠に続く繰り返し)になってしまう、それはどのような場合かを選択肢から選ぶ、という内容です。
問題(出典:サンプル問題セット問13)
次の記述中の に入れる正しい答えを,解答群の中から選べ。ここで,配列の要素番号は1から始まる。
関数 search は,引数 data で指定された配列に,引数 target で指定された値が含まれていればその要素番号を返し,含まれていなければ -1 を返す。data は昇順に整列されており,値に重複はない。関数 search には不具合がある。例えば,data の 場合は,無限ループになる。
〔プログラム〕
〇整数型: search(整数型の配列: data, 整数型: target)
  整数型: low, high, middle

  low ← 1
  high ← dataの要素数

  while (low ≦ high)
    middle ← (low + high) ÷ 2 の商
    if (data[middle] < target)
      low ← middle
    elseif (data[middle] > target)
      high ← middle
    else
      return middle
    endif
  endwhile

  return -1
【解答群】
ア 要素数が 1 で,target がその要素の値と等しい
イ 要素数が 2 で,target が data の先頭要素の値と等しい
ウ 要素数が 2 で,target が data の末尾要素の値と等しい
エ 要素に -1 が含まれている
この問題には、サーチのプログラムであることは示されていますが、何というアルゴリズムであるかは示されていません。
ただし、サーチのアルゴリズムをプログラムで経験していれば、二分探索法だとわかるはずです。
二分探索法だと見抜くポイントは、low、high、middleという名前の変数を使っていることと、「middle ← (low + high) ÷ 2の商」という計算でmiddleを求めていることです。
二分探索法のプログラムでは、配列の探索対象を絞り込むために、現在の探索対象の左端、右端、真ん中の要素番号を示す変数が必要です。
それが、low、high、middleです。
「middle ← (low + high) ÷ 2の商」という計算でmiddleを求めていることからも、これらの変数の役割がわかります。
これは「真ん中は、左端+右端を2で割った商(小数点以下カット)」ということです。
プログラムの誤りを見つけてみましょう。
「data[middle] < target(真ん中の値が目的の値より小さい)」ときは、後側に絞り込むので「low ← middle + 1」としますが、「low ← middle」になっているので、ここが誤りです。
「data[middle] > target(真ん中の値が目的の値より大きい)」ときは、前側に絞り込むので「high ← middle - 1」としますが、「high ← middle」になっているので、ここも誤りです。
それぞれの選択肢で、これらの誤りによって無限ループになるかどうかを考えてみましょう。
選択肢アは、繰り返しの最初の処理でlow=1、high=1、middle=1であり、data[middle] = targetになり「return middle」で処理が終了するので、無限ループになりません。
選択肢イは、繰り返しの最初の処理でlow=1、high=2、middle=1であり、data[middle] = targetになり「return middle」で処理が終了するので、無限ループになりません。
選択肢ウは、繰り返しの最初の処理でlow=1、high=2、middle=1であり、data[middle] < targetになり後側に絞り込みますが、誤りの「low ← middle」ではlowの値が変わらないので、繰り返しの次の処理でmiddleが1のままとなり、これが永遠に繰り返されて、無限ループになります。
したがって、選択肢ウが正解です。
選択肢エの要素に-1が含まれていることは、無限ループになることとは無関係です。
今回は、「サーチのアルゴリズム」のポイントと攻略法を解説しました。
このテーマが苦手だった受験者の参考になれば幸いです。
それでは、またお会いしましょう!
label 関連タグ免除試験を受けた 74.9% の方が、科目A免除資格を得ています。
※独習ゼミは、受験ナビ運営のSEプラスによる試験対策eラーニングです。
2進数を使ったプログラム|つまづきやすいポイントと攻略法 徹底解説!
update
サーチのアルゴリズム|つまづきやすいポイントと攻略法 徹底解説!
update
ソートのアルゴリズム|つまづきやすいポイントと攻略法 徹底解説!
update
再帰呼び出し|つまづきやすいポイントと攻略法 徹底解説!
update
モジュール結合度|つまづきやすいポイントと攻略法 徹底解説!
update
RAID|つまづきやすいポイントと攻略法 徹底解説!
update
MIPS|つまづきやすいポイントと攻略法 徹底解説!
update
暗号化|つまづきやすいポイントと攻略法 徹底解説!
update
IPアドレス|つまづきやすいポイントと攻略法 徹底解説!
update
ネットワークの識別番号|つまづきやすいポイントと攻略法 徹底解説!
update『プログラムはなぜ動くのか』(日経BP)が大ベストセラー
IT技術を楽しく・分かりやすく教える“自称ソフトウェア芸人”
大手電気メーカーでPCの製造、ソフトハウスでプログラマを経験。独立後、現在はアプリケーションの開発と販売に従事。その傍ら、書籍・雑誌の執筆、またセミナー講師として活躍。軽快な口調で、知識0ベースのITエンジニアや一般書店フェアなどの一般的なPCユーザの講習ではダントツの評価。
お客様の満足を何よりも大切にし、わかりやすい、のせるのが上手い自称ソフトウェア芸人。
主な著作物
- 「プログラムはなぜ動くのか」(日経BP)
- 「コンピュータはなぜ動くのか」(日経BP)
- 「出るとこだけ! 基本情報技術者」 (翔泳社)
- 「ベテランが丁寧に教えてくれる ハードウェアの知識と実務」(翔泳社)
- 「ifとelseの思考術」(ソフトバンククリエイティブ) など多数